

 Моят гараж

 Моите карти

 АвтоБОТ

 Назад
 известия
 съобщения
 АвтоБОТ


Toyota Corolla под контрол на ChatGPT, Claude и Grok
 10:38 | 28.10.2026
 Време за четене: 03:15 мин.
Тест на празен паркинг разкри лимитите на ИИ зад волана
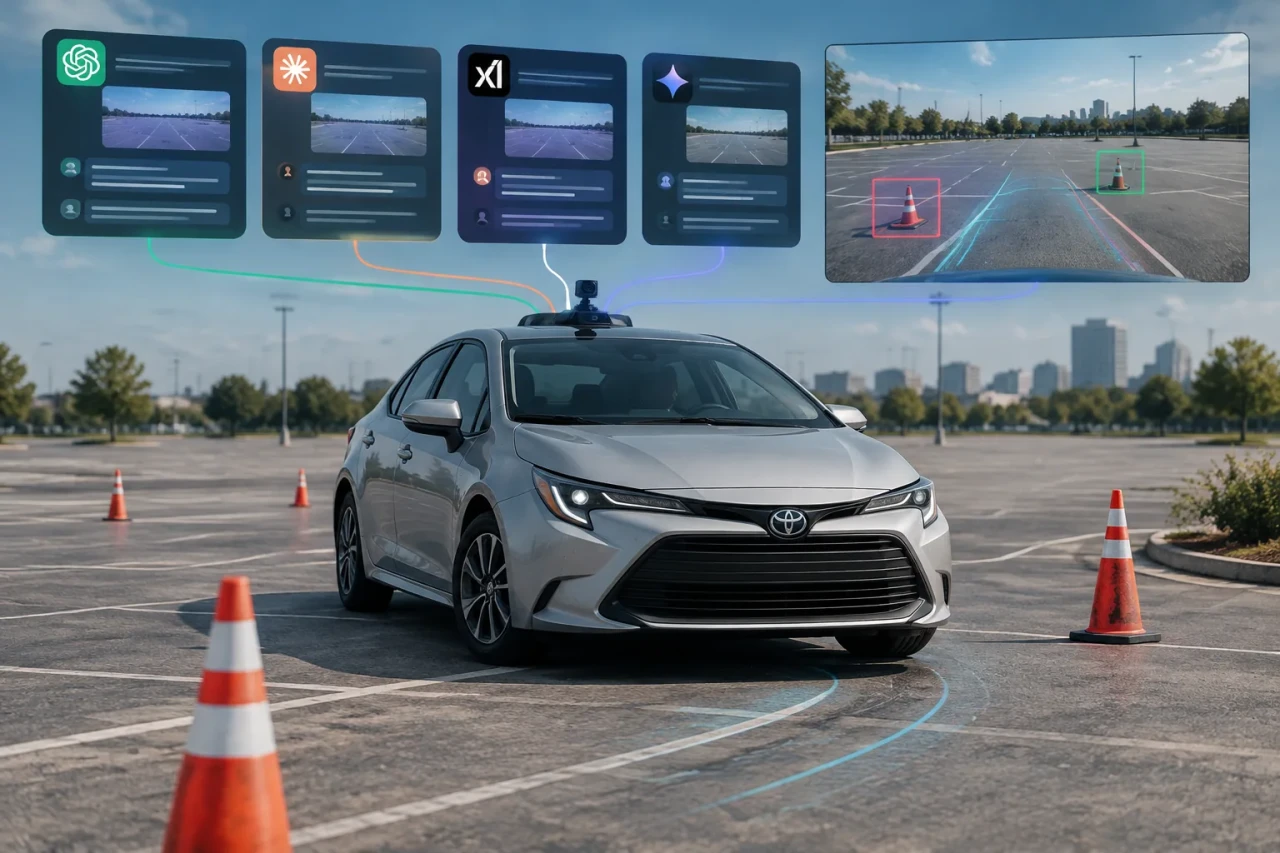
Американски инженер даде на невронните мрежи ChatGPT, Claude и Grok пълен контрол над истинска Toyota Corolla, за да провери как се справят с управление в реални условия. Резултатът е показателен: моделите успяват да подават команди към автомобила, но основните им слабости излизат наяве веднага — особено при реакцията и преценката на разстояния.
Експериментът е публикуван в X от потребител с псевдоним DrivingBench и включва общо четири модела (две различни версии на ChatGPT, плюс Claude и Grok). В повечето сценарии те се държат нестабилно, а един модел се откроява като най-успешен по изпълнение на маршрута.
Контекстът е важен: тези невронни мрежи не са проектирани да „виждат“ света като системи за автономно управление, нито да вземат решения за части от секундата. Затова тестът показва не толкова „автопилот“, колкото границите на подхода, при който общи езикови модели (LLM – големи езикови модели) получават визуална информация и връщат текстови команди към колата.
Инженерът свързва моделите с изкуствен интелект директно към системите за управление на волана, дросела и спирачките на Toyota Corolla на празен паркинг. Тъй като моделите не са създадени да интерпретират динамична среда и да реагират мигновено, той изгражда схема, при която камера подава визуални данни като контекст на заявка, а моделите връщат текстови команди — за ъгъл на завиване, процент на дросела и спирачна сила.
Основният проблем се оказва закъснялата реакция. Инженерът дава пример: когато е трябвало воланът да се завърти на 15 градуса, автомобилът вече е бил отклонен значително от курса си. Втори ключов недостатък е липсата на 3D пространствено възприятие, което води до слаба оценка на разстоянията до препятствия.
Наблюдавани са и противоречиви команди — например подаване на 100% мощност към двигателя, съчетано едновременно с команда за пълно спиране. Това подчертава колко трудно е за подобни модели да поддържат последователен контрол, когато трябва да управляват в реално време.
В класирането инженерът посочва ChatGPT-6 Astra AI като победител, но с уточнението, че и на него му липсва достатъчна скорост на реакция. Моделът се проваля първоначално, но при втори опит завършва маршрута за 5 минути и 22 секунди, като се „поучава“ от предишните грешки.
На второ място е Claude Fable 5.1, който изминава 45% от маршрута. Grok 4.6 отпада след 11%, а GPT-5.6 Sol завършва едва 6%.
Свали мобилното приложение MyVe и ползвай всички услуги напълно безплатно:

 Използвай местоположение
